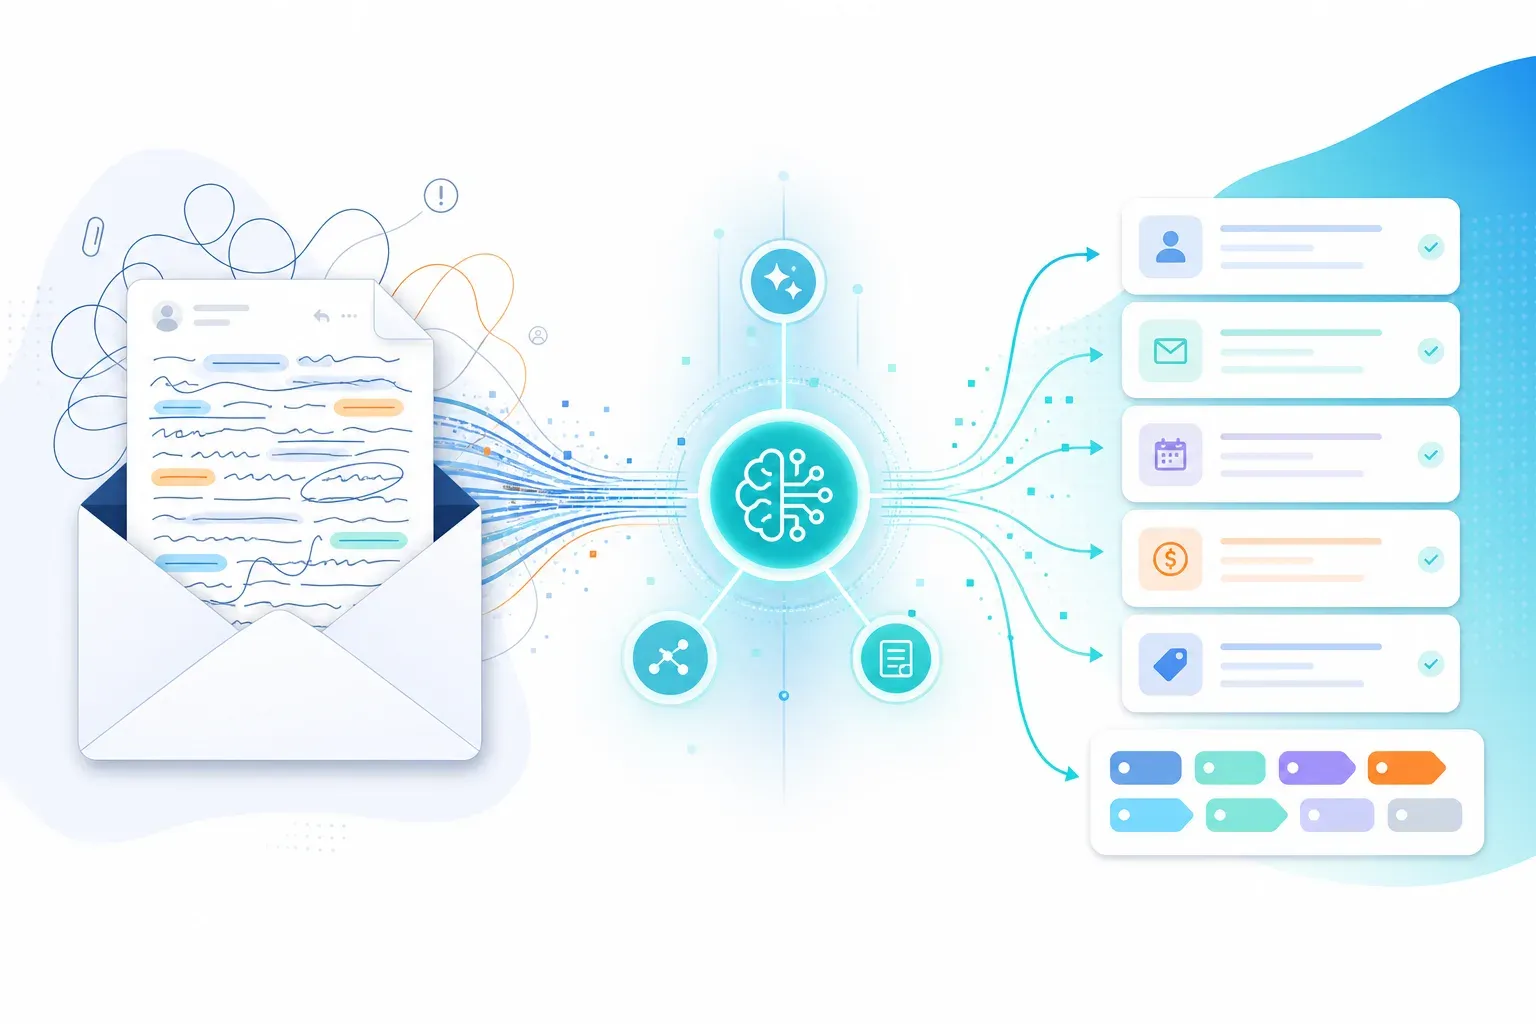
Veröffentlicht am 17. Juni 2026, ist Zammad 7.1 ein fokussiertes, praxisnahes Update mit einem klaren Leitthema: chaotische, unstrukturierte Anfragen in saubere, strukturierte und nutzbare Ticketdaten zu verwandeln — ohne jemals die Kontrolle darüber abzugeben, wo diese Daten liegen.
War Zammad 7.0 noch der große Schritt, KI-Agenten überhaupt in den Helpdesk zu bringen, lässt 7.1 diese Agenten an der lästigsten Aufgabe im Support arbeiten: der Dateneingabe. Hier ist, was sich wirklich geändert hat, warum es zählt und worauf Sie achten müssen, bevor Sie auf „Update“ klicken.
Das Thema von 7.1: Struktur ab der ersten Sekunde
Jedes Support-Team kennt den Schmerz. Ein Kunde schreibt eine ausschweifende E-Mail. Irgendwo in dieser Textwand stecken eine Rechnungsnummer, ein Produktname, eine Seriennummer und ein Problem, das in die Buchhaltungs-Queue gehört — aber nichts davon ist strukturiert. Ein Agent muss alles lesen, interpretieren und die Werte manuell in Ticketfelder übertragen, bevor irgendeine Automatisierung überhaupt greifen kann.
Zammad 7.1 geht dieses Problem von zwei Seiten an: deterministische Regex-Extraktion für vorhersehbare Muster und KI-gestützte Extraktion für alles, was sich nicht an Regeln hält.
Informationsextraktion mit Regex
Admins können jetzt reguläre Ausdrücke (Regex) in Postmaster-Filtern verwenden, um gezielt Text aus eingehenden E-Mails zu extrahieren und in Filteraktionen weiterzuverwenden. Damit lassen sich Ticketattribute automatisch anhand des Inhalts einer E-Mail befüllen — nicht nur anhand von Absender oder Betreff.
Typische Anwendungsfälle:
- Bestell- oder Rechnungsnummer aus einer strukturierten Benachrichtigungs-E-Mail extrahieren und in ein eigenes Feld schreiben.
- System- oder Asset-ID aus automatisierten Monitoring-Alarmen erfassen.
- Referenzcode aus einer Formular-Vorlage auslesen und entsprechend routen.
Da Regex vollständig deterministisch ist, eignet es sich ideal für klar definierte, gleichbleibende Muster — genau die Art, die maschinell erzeugte E-Mails und Formulareingaben den ganzen Tag liefern.
Neuer KI-Agent: der Text-Extractor
Regex ist perfekt, solange sich das Format nie ändert. Echte Kunden sind weniger kooperativ. Der neue KI-Text-Extractor ist für natürliche Sprache gebaut — er analysiert eingehende Tickets und erkennt Informationen wie Kontaktnamen, Produktnennungen oder Rechnungsnummern, selbst wenn diese keinem einheitlichen Format folgen.
Die extrahierten Werte werden direkt in Ticketattribute geschrieben, das bedeutet:
- Weniger manuelles Kopieren und Einfügen für Agenten.
- Höhere, konsistentere Datenqualität.
- Strukturierte, nutzbare Informationen ab dem Moment, in dem ein Ticket eintrifft — bereit für nachgelagerte Automatisierung, SLAs und Reporting.
Regex vs. KI — nutzen Sie beides
Neuer KI-Agent: der Ticket-Tagger
Der zweite neue Agent, der KI-Ticket-Tagger, reichert eingehende Tickets automatisch mit relevanten Tags an. Bei einem plötzlichen Anstieg von „App-Abstürzen“ oder einer stetig wachsenden Zahl von „Abrechnungs“-Anfragen hält automatisches Tagging Ihre Tickets strukturiert, durchsuchbar und bereit für Trendanalysen — auch wenn das Volumen wächst.
Hier liegt der eigentliche langfristige Nutzen. Konsistentes Tagging von Tag eins an bedeutet:
- Bessere Suche über historische Tickets hinweg.
- Zuverlässige Trenderkennung — Sie erkennen die Welle an Absturzmeldungen, bevor sie zur Flut wird.
- Sauberere Analysen ohne nachträgliche Aufräumprojekte.
Datenschutz bleibt im Zentrum
Ein Punkt, der für europäische und regulierte Organisationen wichtig ist: Zammads Design lässt die Kontrolle fest in Ihren Händen. KI-Funktionen lassen sich mit dem Modell und Deployment verbinden, das zu Ihrer Compliance passt — sei es eine kommerzielle API oder ein selbst gehostetes Open-Weights-Modell innerhalb Ihres eigenen Netzwerks.
Datenhoheit
Wenn Sie die komplette Anleitung zum Betrieb von Zammads KI auf eigenen Servern suchen — das Docker-Setup, die Hosting-Kosten und die Auswahl eines lokalen LLM, damit kein einziges Ticket eine externe API berührt — beschreibt das OpenTicketAI-Team genau das in Zammad 7.0 On-Premise: Full AI Power Without Your Data Leaving the Server. Dieser Artikel setzt einen anderen Schwerpunkt: die neuen Extraktionsfunktionen von 7.1 und was sie für Ihre tägliche Datenqualität bedeuten — nicht die zugrunde liegende On-Premise-Infrastruktur.
Vor dem Update: das Kleingedruckte
Zammad 7.1 ist für selbst gehostete Instanzen kein „Klicken und Vergessen“-Update. Lesen Sie diesen Abschnitt aufmerksam.
- Neue Paket-Repositories. Self-hosted-Nutzer müssen vor dem Update auf die neuen Paket-Repositories migrieren. Wird dieser Schritt übersprungen, bricht der Upgrade-Pfad.
- Elasticsearch 7 läuft aus. Der Support für Elasticsearch 7 endet mit Zammad 7.2. Wenn Sie noch auf ES 7 sind, planen Sie jetzt die Migration auf eine unterstützte Version — 7.1 ist Ihr Warnschuss.
- Veraltetes
es-ca-Locale. Dases-ca-Locale (Katalanisch) wurde deaktiviert. - Content-Security-Policy. Prüfen Sie die Änderungen an der Standard-CSP, falls Sie eigene Integrationen oder eingebettete Widgets betreiben.
Vor dem Produktivbetrieb testen
Sollten Sie updaten?
Für die meisten Teams: ja, aber mit Plan.
- Wenn Sie ein hohes Volumen an strukturierten, maschinell erzeugten E-Mails verarbeiten, rechtfertigen schon die Regex-Postmaster-Filter das Update.
- Wenn Ihr Posteingang von Freitext-Kundennachrichten dominiert wird, reduzieren der KI-Text-Extractor und der Ticket-Tagger Ihre manuelle Triage-Zeit spürbar.
- Wenn Sie noch auf Elasticsearch 7 sind, nehmen Sie 7.1 als Anlass, Ihre ES-Migration zu planen, bevor 7.2 Sie dazu zwingt.
Wie Softoft helfen kann
Die Einführung von Zammads neuen KI-Agenten ist in der Theorie unkompliziert und in der Praxis voller Sonderfälle — Modellauswahl, Datenfluss-Design, Regex-Tuning und die Orchestrierung von Self-Hosted-Upgrades belohnen Erfahrung.
Ob Sie ein sicheres, gestaffeltes Upgrade benötigen, Hilfe beim Anbinden der neuen KI-Extraktions-Agenten oder ein vollständig souveränes On-Premise-KI-Setup — Softoft übernimmt die Implementierung von Anfang bis Ende.
<template #actions>